Sama skalowalność API nie gwarantuje terminowego doręczenia: API może poprawnie przyjąć zlecenie wysyłki kampanii na Black Friday, choć wiadomości wciąż czekają na dostarczenie. Jeśli requesty napływają szybciej niż infrastruktura jest w stanie je obsłużyć, dochodzi do kolejkowania wiadomości. Potwierdzenie przyjęcia żądania nie oznacza więc, że wiadomość dotarła już do odbiorcy.
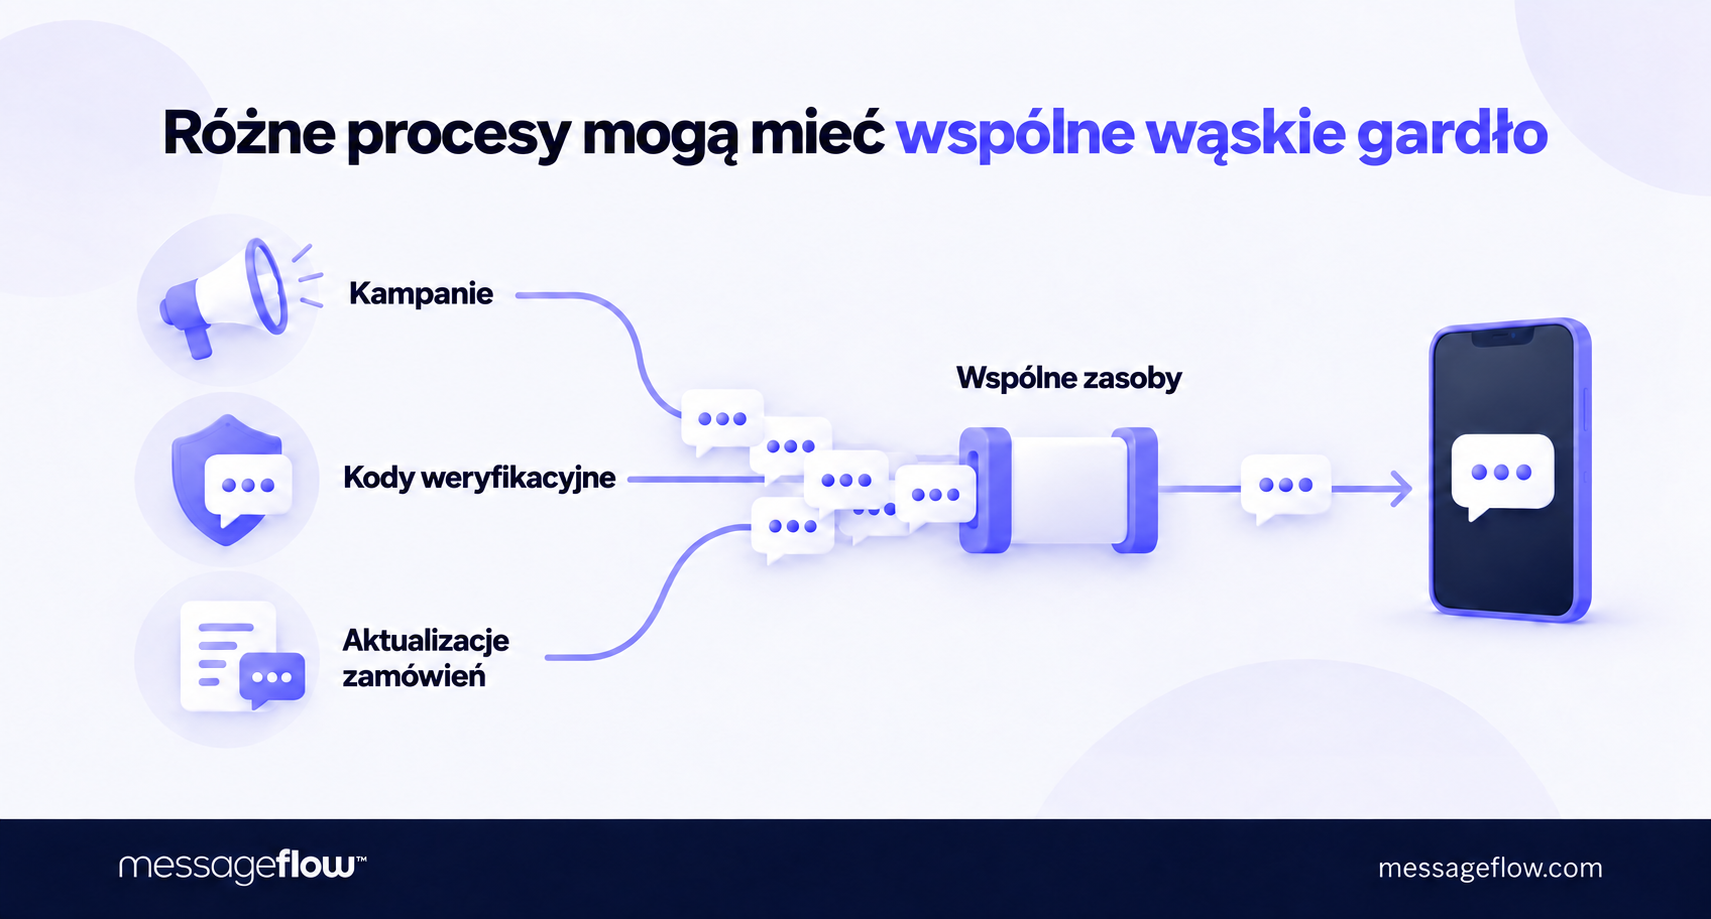
Podczas Black Friday z tej samej infrastruktury może korzystać kilka procesów jednocześnie. Kampania przyciąga klientów do sklepu. Ich działania uruchamiają wysyłkę kodów weryfikacyjnych, potwierdzeń zamówień i powiadomień o dostawie zanim jeszcze zakończy się wysyłka promocyjna. Jeśli wiadomości te konkurują o ograniczoną przepustowość, dobra kampania marketingowa może utrudnić komunikację potrzebną do sfinalizowania zakupów.
💡 Skalowalność API oceniaj więc przez pryzmat całego tego ruchu oraz czasu, w którym poszczególne wiadomości powinny dotrzeć do klientów. Kod weryfikacyjny musi przyjść zanim straci ważność. Potwierdzenie zamówienia powinno uspokoić klienta, który właśnie zapłacił. Promocyjny SMS, e-mail czy mobile push ma dotrzeć, gdy odbiorca może jeszcze skorzystać z oferty.
Zacznij ocenę gotowości od tych założeń. To one określają potrzebną przepustowość, priorytety wysyłki i moment, w którym zespół powinien zareagować na opóźnienia.
Jakie problemy ujawniają się dopiero przy szczytowym ruchu?
Infrastruktura, która sprawnie obsługuje zwykły dzień biznesowy może mieć słabe punkty niewidoczne przy mniejszym obciążeniu. Black Friday ujawnia je, gdy jednocześnie rośnie liczba kampanii, zakupów i automatycznych powiadomień.
Przyjrzyj się trzem sytuacjom:
- Oddzielne procesy korzystają ze wspólnych zasobów. Wiadomości promocyjne i transakcyjne mogą pochodzić z różnych aplikacji, ale podlegać temu samemu limitowi konta lub korzystać z tej samej infrastruktury wysyłkowej. Sprawdź, gdzie te procesy się łączą. Osobne ustawienia kampanii nie muszą oznaczać niezależnej przepustowości.
- Ponowienia żądań zwiększają obciążenie. Gdy żądanie kończy się błędem lub aplikacja nie otrzymuje odpowiedzi w wyznaczonym czasie, może automatycznie spróbować ponownie. Jeśli kilka systemów robi to natychmiast, dokładają ruch do już przeciążonej usługi. Microsoft opisuje w zaleceniach dotyczących ponowień jak zbyt częste próby mogą utrudniać jej powrót do sprawnego działania.
- Nagły skok ruchu wyprzedza zwiększenie zasobów. Uruchomienie dodatkowych zasobów wymaga czasu. System może radzić sobie z utrzymującym się dużym obciążeniem, a mimo to mieć problem z gwałtownym wzrostem liczby żądań w chwili startu kampanii. Dlatego kontrola przeciążenia musi działać również wtedy, gdy infrastruktura dopiero zwiększa dostępną moc.
💡 Poproś swój zespół infrastruktury o wskazanie, który wspólny komponent jako pierwszy osiągnie granicę wydajności i jak zareagują wtedy pozostałe systemy. Odpowiedź pozwoli przygotować konkretny scenariusz testu przed najważniejszym okresem sprzedażowym.
BEZPŁATNY RAPORT
AI w komunikacji z klientem
Zobacz, jak liderzy rynku wdrażają AI, omnichannel i RCS. Wnioski 23 ekspertów z Google, Microsoft i Allegro.

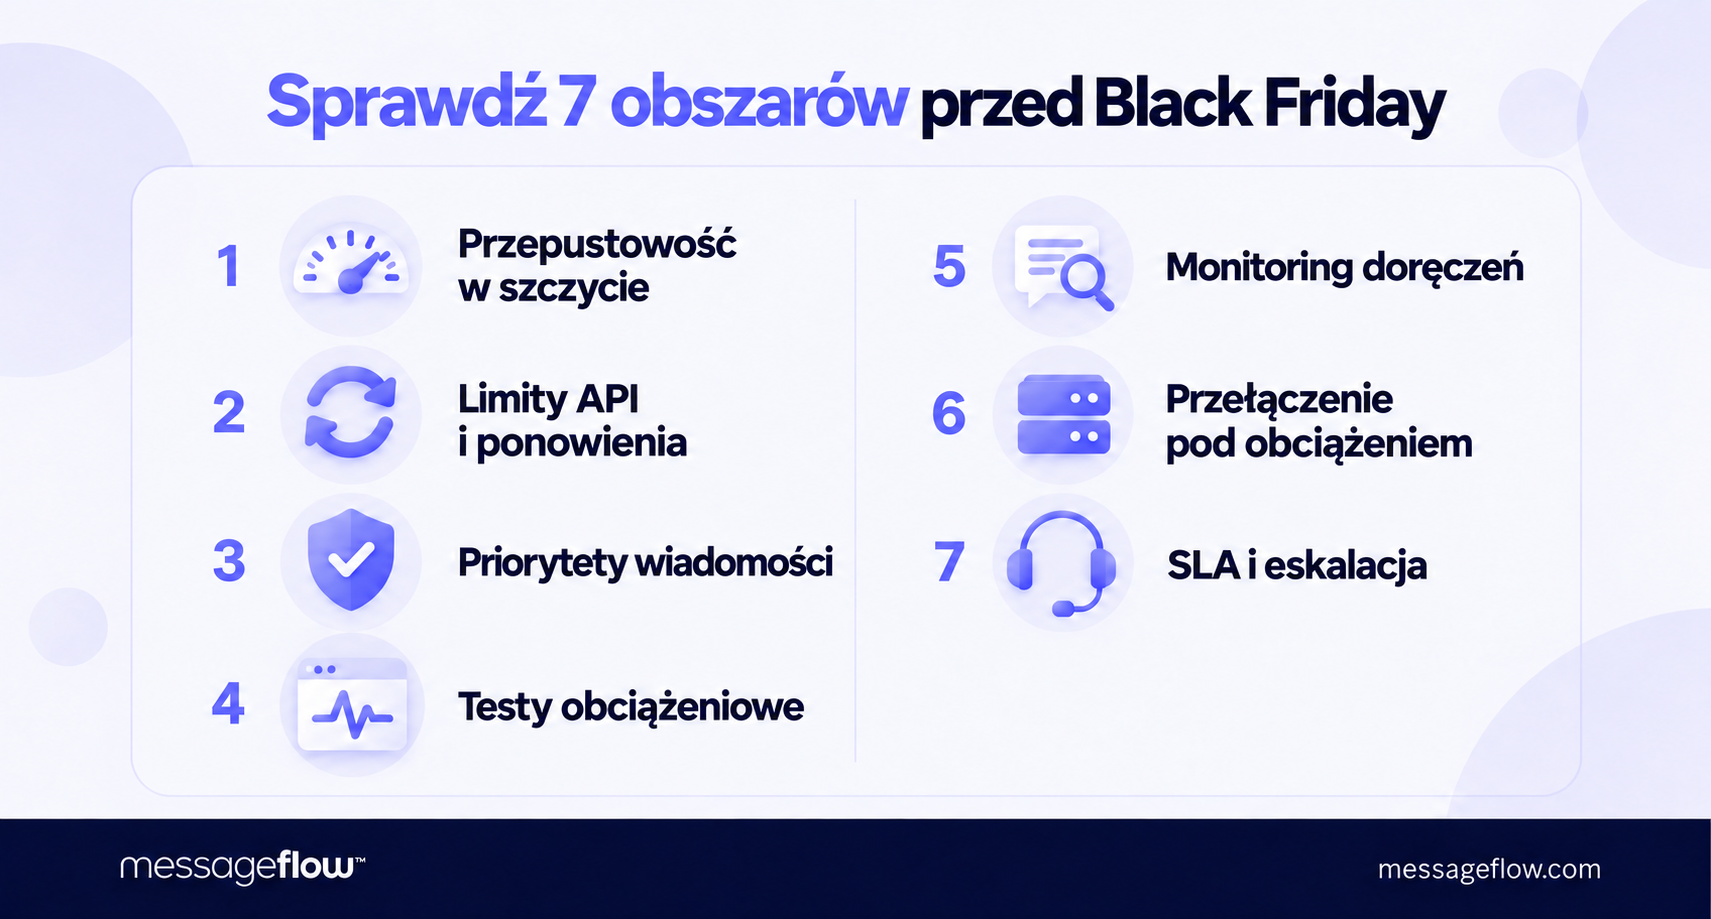
1. Dopasuj przepustowość do największego natężenia wysyłek
Oceniając skalowalność API, zaplanuj potrzebną przepustowość na podstawie najbardziej intensywnego spodziewanego okresu Black Friday. Dobowa liczba wiadomości może ukrywać krótkie, duże spiętrzenie: wysłanie 180 tys. wiadomości w dziesięć minut wymaga innej wydajności niż rozłożenie ich na dziesięć godzin.
Zestaw harmonogram kampanii z prognozowaną liczbą wiadomości transakcyjnych. Dla wysyłek SMS, e-mail i mobile push określ liczbę odbiorców, godzinę rozpoczęcia, czas na wysyłkę oraz dodatkową komunikację, którą mogą uruchomić działania klientów. Uwzględnij też nakładające się działania innych zespołów, np. kampanię lojalnościową zaplanowaną na moment wzrostu liczby potwierdzeń zamówień.
Następnie sprawdź co dokładnie oznaczają deklarowane parametry:
| Parametr | Ustal |
|---|---|
| Liczba żądań API na sekundę | Jak szybko aplikacja może zlecać wysyłkę i czy jedno żądanie obejmuje jedną, czy wiele wiadomości. |
| Liczba wiadomości lub segmentów SMS na sekundę | Jak szybko dostawca może przetwarzać lub wysyłać wiadomości oraz którego etapu dotyczy podana wartość. |
| Przepustowość dla danego kraju, sieci lub nadawcy | Czy obowiązują dodatkowe ograniczenia, niższe od łącznego limitu konta. |
W przypadku SMS-ów na obliczenia wpływa długość treści. Przykładowa kampania obejmująca 180 tys. dwusegmentowych SMS-ów oznacza wysyłkę 360 tys. segmentów. Aby wysłać je w dziesięć minut, potrzeba średnio 600 segmentów na sekundę jeszcze przed doliczeniem ruchu transakcyjnego i zapasu na wahania obciążenia. Pamiętaj jednocześnie, że tak obliczone wartości nie gwarantują doręczenia wszystkich wiadomości na telefony w tym czasie.
✅ Potwierdź z dostawcą: czy przepustowość dostępna dla Twojego konta wystarczy do obsługi zaplanowanych wysyłek na wybranych rynkach i w wymaganym czasie? Ustal czy jej zwiększenie wymaga wcześniejszego zgłoszenia, zmiany konfiguracji lub dodatkowych ustaleń umownych.
Gwałtowny wzrost liczby wysyłanych e-maili może pogorszyć reputację domeny i adresów IP nadawcy, a w konsekwencji obniżyć dostarczalność. Dlatego większe wysyłki warto planować z wyprzedzeniem i przygotować je wspólnie z dostawcą usług. – Grzegorz Gorczyca, Solutions Architect & Team Lead, MessageFlow
2. Sprawdź limity API i zasady ponawiania żądań
Ustal jak aplikacja ma reagować po osiągnięciu limitu żądań API. Bez określonych zasad chwilowe ograniczenie może zatrzymać kampanię lub zacząć generować rosnącą liczbę nieobsłużonych zleceń wysyłki.
Zapytaj dostawcę czego dotyczy limit: konta, konkretnego endpointu, nadawcy czy liczby żądań w określonym przedziale czasu. Sprawdź też czy dopuszcza on krótkotrwałe skoki ruchu i jak sygnalizuje przekroczenie limitu. Odpowiedź HTTP 429 Too Many Requests zwykle informuje o ograniczeniu liczby żądań, a dokumentacja powinna wyjaśniać jak integracja ma na nią zareagować.
Następnie poproś swój zespół techniczny o sprawdzenie trzech zachowań:
- Odstępy między próbami. Jeśli dostawca zwraca nagłówek Retry-After, aplikacja powinna odczekać wskazany czas. W pozostałych przypadkach powinna stosować zasady opisane w dokumentacji, np. stopniowo wydłużać przerwy i dodawać niewielkie losowe opóźnienie, aby wiele aplikacji nie ponawiało żądań jednocześnie.
- Zakończenie nieskutecznych prób. Błędne dane uwierzytelniające lub niepoprawna struktura żądania wymagają korekty. Przy błędach przejściowych ustal maksymalną liczbę ponowień i sposób rejestrowania zleceń, których nadal nie udało się obsłużyć.
- Koordynacja mechanizmów ponawiania. Aplikacja, biblioteka kliencka i system obsługujący zadania w tle mogą niezależnie ponawiać tę samą operację. Sprawdź, czy łącznie nie wykonują więcej prób niż zakładał zespół.
Takie podejście odpowiada zaleceniom Microsoft: ograniczaj liczbę prób, dobieraj odstępy i koordynuj ponowienia między warstwami aplikacji.
Osobno potraktuj przekroczenie czasu oczekiwania na odpowiedź. Jej brak nie rozstrzyga, czy dostawca przyjął zlecenie. Ustal jak to zweryfikować przed ponowną próbą. Zapytaj też o obsługę idempotencji – mechanizmu, dzięki któremu powtórzenie tego samego żądania nie uruchamia drugiej wysyłki oraz warunki jego działania.
✅ Sprawdź przed Black Friday: zasymuluj odpowiedź o przekroczeniu limitu. Aplikacja powinna ponawiać żądania zgodnie z ustalonymi zasadami, sygnalizować nierozwiązane błędy i korzystać z zabezpieczeń przed podwójną wysyłką.
3. Zapewnij wiadomościom krytycznym pierwszeństwo przed kampaniami
Ustal które wiadomości mają mieścić się w przepustowości gdy infrastruktura próbuje przetworzyć szczególnie dużą liczbą requestów. Zespoły marketingu, produktu i IT powinny jeszcze przed startem kampanii uzgodnić, które wysyłki mogą poczekać.
O priorytecie powinny decydować skutki opóźnienia:
- Uwierzytelnianie i bezpieczeństwo: kody weryfikacyjne, linki do resetowania hasła i pilne alerty bezpieczeństwa potrzebują ścieżki wysyłki chronionej przed przeciążeniem pozostałym ruchem.
- Standardowa komunikacja transakcyjna: aktualizacje zamówień, potwierdzenia zakupu i faktury wymagają ustalonego czasu doręczenia, ale nie muszą mieć takiego samego priorytetu jak kod niezbędny do dokończenia zakupu.
- Kampanie promocyjne: określ, które wysyłki SMS, e-mail i mobile push można opóźnić lub wstrzymać, aby zwolnić zasoby dla pilniejszej komunikacji.
Zapytaj swój zespół techniczny i dostawcę jak egzekwują ten podział. Za oznaczeniem wiadomości jako priorytetowej powinien stać konkretny mechanizm: zarezerwowana przepustowość, oddzielne zasoby przetwarzania lub kolejki obsługujące pilne wiadomości w pierwszej kolejności. Takie rozwiązania opisują m.in. zalecenia Microsoft dotyczące obsługi przeciążeń.
💡 W przypadku pilnych SMS-ów i e-maili MessageFlow Priority zapewnia dedykowaną ścieżkę przetwarzania, która omija standardowe kolejki w infrastrukturze MessageFlow. Jest to dodatkowa usługa przeznaczona m.in. dla kodów OTP i alertów bezpieczeństwa, mająca zapewnić szybkie i skuteczne dostarczenie Twojej komunikacji krytycznej.
Określ też jak długo wiadomość może czekać na wysłanie. Jeśli system to umożliwia, ustaw czas ważności zlecenia, po którym nieaktualna oferta lub wygasły kod zostaną usunięte z kolejki. Sprawdź zakres tego ustawienia: limit oczekiwania u dostawcy nie musi obejmować wiadomości przekazanych już do operatora.
✅ Sprawdź przed Black Friday: uruchom jednocześnie testowy ruch promocyjny i pilne wiadomości. Zweryfikuj czy te drugie mieszczą się w uzgodnionych limitach czasu, gdy obciążenie kampanią rośnie.
4. Przeprowadź testy obciążeniowe API odzwierciedlające planowane wysyłki
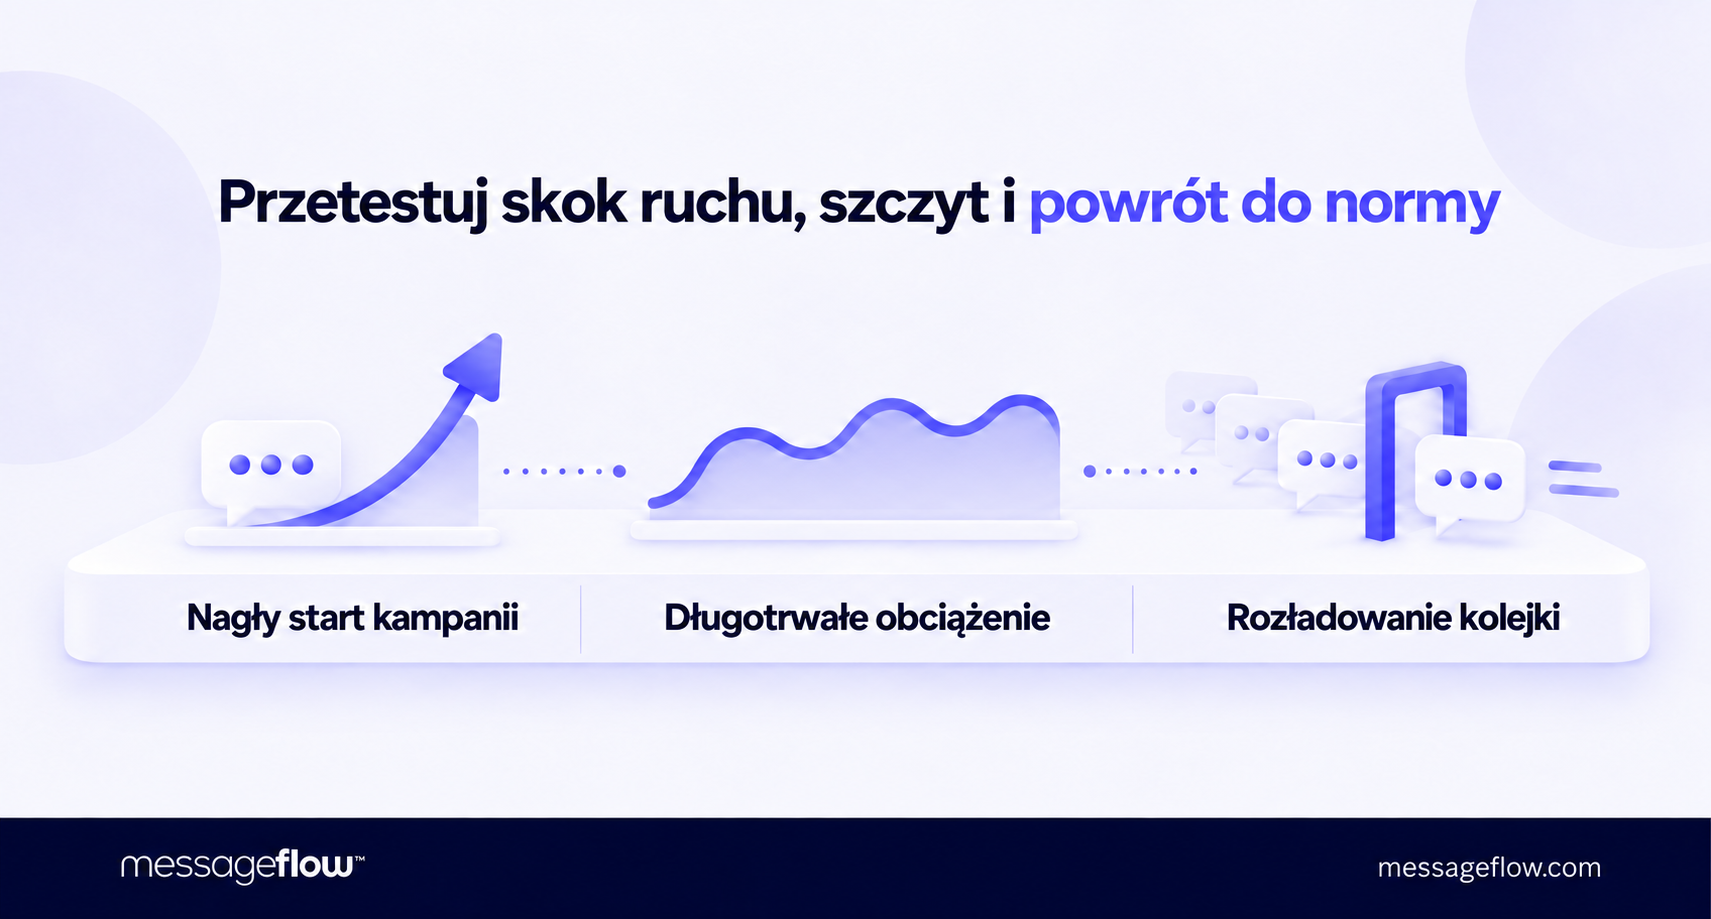
Test powinien zweryfikować skalowalność API przy obciążeniu planowanym na Black Friday i wskazać, co trzeba poprawić przed startem kampanii. Oprzyj scenariusz na prognozie ruchu: uwzględnij proporcje SMS-ów, e-maili i powiadomień push, typowe rozmiary wiadomości, liczbę wiadomości w pojedynczym zleceniu oraz ruch transakcyjny.
Sprawdź trzy sytuacje:
| Warunki testu | Zweryfikuj |
|---|---|
| Nagły start kampanii | Czy system obsługuje spodziewany skok ruchu bez przekraczania uzgodnionych limitów czasu i poziomu błędów. |
| Długotrwałe duże obciążenie | Czy wydajność pozostaje stabilna przez cały intensywny okres, a nie tylko podczas krótkiej próby. |
| Powrót do zwykłego natężenia ruchu | Czy system rozładowuje kolejkę w akceptowalnym czasie, mimo że nadal przyjmuje nowe wiadomości. |
Przeprowadź test w środowisku możliwie zbliżonym do produkcyjnego. Zapisz różnice, które ograniczają miarodajność wyników. Microsoft w swoich zaleceniach testowych wskazuje na potrzebę odwzorowania rzeczywistego ruchu, ustalenia kryteriów zaliczenia i dobrania rodzaju testu do ocenianego ryzyka.
Uwzględnij przy tym również odbieranie informacji zwrotnych. Jeśli integracja korzysta z webhooków przekazujących statusy doręczenia, sprawdź czy aplikacja nadąża z ich przetwarzaniem podczas nowych wysyłek. Test kończący się na przyjęciu żądania przez dostawcę pomija tę część procesu.
Zanim wygenerujesz obciążenie usług dostawcy, uzgodnij z nim zakres próby. Do rzeczywistych wysyłek używaj kontrolowanej listy odbiorców testowych. W wynikach rozróżnij testy z symulowanymi odpowiedziami dostawcy od tych, które obejmują faktyczną infrastrukturę wysyłkową.
✅ Przed testem ustal kryteria zaliczenia: wymaganą przepustowość, dopuszczalne opóźnienia i poziom błędów oraz maksymalny czas rozładowania kolejki. Zaznacz których etapów dotyczą pomiary, aby szybka odpowiedź API nie została uznana za dowód szybkiego doręczenia. Zostaw czas na usunięcie wykrytego ograniczenia i ponowne sprawdzenie poprawionego elementu przed Black Friday.
W testach obciążeniowych najczęściej pomija się raportowanie, zwłaszcza odbieranie statusów wysyłek przez webhooki. Im więcej wiadomości, tym więcej aktualizacji musi obsłużyć system klienta. Warto sprawdzić zawczasu, czy nadąży z ich przetwarzaniem przy planowanym obciążeniu. Jeśli mechanizm odbierający statusy korzysta z tej samej infrastruktury co sklep internetowy, jego przeciążenie może zakłócić również działanie sklepu. — Grzegorz Gorczyca, Solutions Architect & Team Lead, MessageFlow
5. Monitoruj opóźnienia na dalszych etapach wysyłki
Monitoring API powinien pomóc zespołowi szybko ustalić, gdzie powstaje problem: w Twojej aplikacji, na platformie komunikacyjnej czy po przekazaniu wiadomości do operatora lub dostawcy poczty.
Połącz dane o ruchu API z dostępnymi informacjami o wysyłce i doręczeniach w poszczególnych kanałach:
| Wskaźnik | Wykryjesz |
|---|---|
| Liczba żądań, błędów i ponowień | Zbliżanie się do limitów, problemy ze zlecaniem wysyłek i dodatkowe obciążenie wywołane kolejnymi próbami. |
| Czas odpowiedzi API, w tym p95 lub p99 | Powolne żądania, które mogą pozostać niewidoczne w średniej. Wartość p95 oznacza czas, w którym mieści się 95% odpowiedzi. |
| Długość kolejki i czas oczekiwania najstarszej wiadomości, jeśli są dostępne | Narastający backlog oraz ryzyko, że wiadomości nie zostaną wysłane, zanim stracą aktualność. |
| Statusy wysyłki i doręczenia | Etap, na którym wiadomości przestają być obsługiwane zgodnie z oczekiwaniami, z podziałem na kanał, kraj lub sieć odbiorcy oraz rodzaj komunikacji. |
| Opóźnienie przetwarzania webhooków | Sytuację, w której aktualizacje statusów napływają szybciej, niż aplikacja je przetwarza. |
Sprawdź znaczenie poszczególnych statusów. Przyjęcie e-maila przez serwer pocztowy, raport doręczenia SMS-a i informacja o dostarczeniu powiadomienia push opisują różne etapy oraz dają różny zakres wiedzy o losie wiadomości. Ustal co raportuje dostawca zanim połączysz te dane w jeden wskaźnik dostarczalności.
Oddziel też opóźnienie raportowania od opóźnienia doręczenia. Brak aktualizacji statusu wymaga sprawdzenia, ale sam w sobie nie potwierdza, że wiadomość nie dotarła.
Każdy alert dotyczący kluczowej komunikacji powinien mieć przypisaną osobę odpowiedzialną i określoną reakcję. Rosnący czas oczekiwania w kolejce może oznaczać konieczność spowolnienia kampanii, a powtarzające się błędy wysyłki kodów pilną interwencję IT. Progi alarmowe ustal na podstawie uzgodnionych wymagań i wyników testów. Takie powiązanie alertów z wpływem na użytkownika zaleca również Microsoft w wytycznych monitoringu.
✅ Sprawdź przed Black Friday: wywołaj alert testowy i potwierdź, że właściwa osoba otrzymuje informacje potrzebne do działania: rodzaj komunikacji, której dotyczy problem, czas wystąpienia, przejawy oraz identyfikatory wiadomości lub żądań.
6. Sprawdź wysoką dostępność API i przełączanie na zasoby zapasowe
Zapasowa infrastruktura przyda się podczas awarii tylko jeśli faktycznie przejmie ruch. Sprawdź zarówno sam mechanizm przełączenia, jak i jego przepustowość.
Zacznij od API przyjmującego żądania: czy po awarii aplikacja może połączyć się z działającym punktem dostępu? Następnie sprawdź przetwarzanie wiadomości, kolejki i pozostałe połączenia. Wysoka dostępność API nie wystarczy jeśli awaria innego wspólnego elementu zatrzyma wysyłkę.
Omów z zespołem technicznym i dostawcą cztery kwestie:
- Wykrywanie awarii: co uruchamia przełączenie? Czy mechanizm reaguje również gdy usługa nadal odpowiada, ale działa zbyt wolno?
- Wydajność zasobów zapasowych: czy wystarczy do obsługi niezbędnej komunikacji przy szczytowym ruchu, czy trzeba będzie wstrzymać kampanie?
- Los przyjętych wiadomości: co dzieje się ze zleceniami oczekującymi na wysłanie? Ustal jak system chroni je przed utratą i dublowaniem.
- Wspólne zależności: czy podstawowa i zapasowa ścieżka korzystają z tej samej bramki, regionu chmurowego lub operatora? Określ przed jakimi awariami chroni taki układ.
Microsoft w zaleceniach dotyczących niezawodności wskazuje na potrzebę pomiaru czasu przełączenia i sprawdzenia czy zapasowe zasoby mają wystarczającą wydajność, aby przejąć obciążenie.
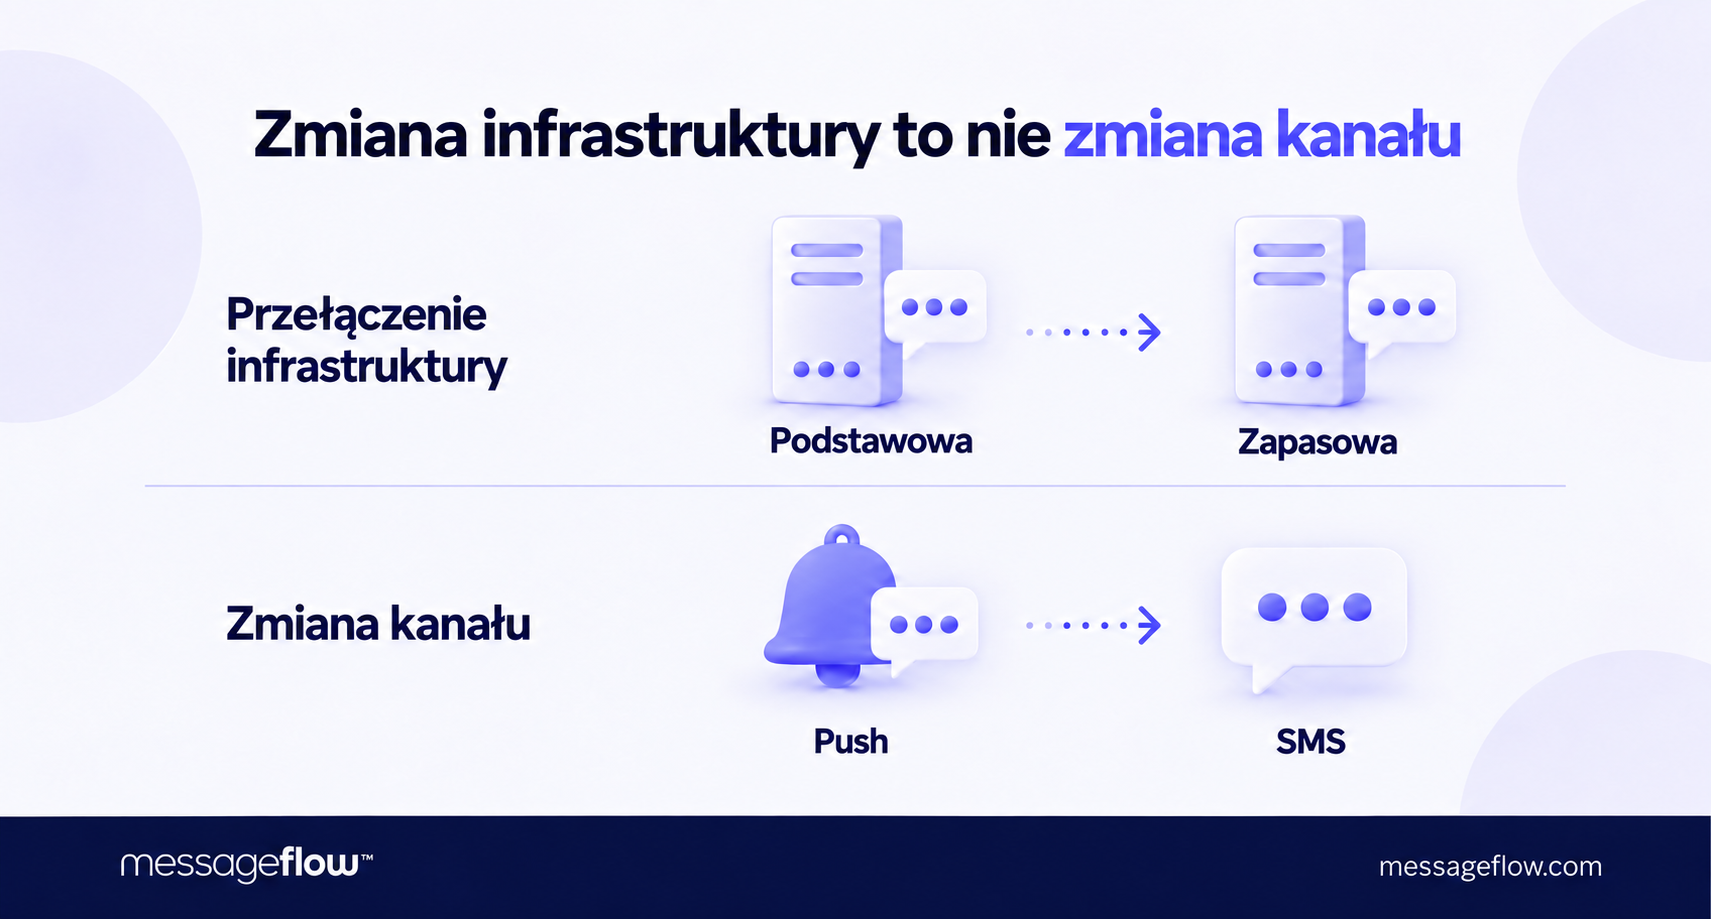
Odróżnij przełączenie infrastruktury od zmiany kanału komunikacji. Zastąpienie powiadomienia push SMS-em oznacza inną ścieżkę wysyłki, koszt i zapotrzebowanie na przepustowość. Jeśli planujesz taki scenariusz awaryjny, uwzględnij dodatkowe SMS-y w obliczeniach obciążenia.
✅ Sprawdź przed Black Friday: przeprowadź kontrolowany test przełączenia przy uzgodnionym natężeniu ruchu. Odnotuj czas przerwy w działaniu, statusy wiadomości i czynności wymagające ręcznej interwencji. Sprawdź również, czy powrót do podstawowej infrastruktury nie powoduje kolejnych zakłóceń.
7. Sprawdź zakres SLA i przećwicz obsługę incydentu
Jeszcze przed Black Friday ustal jakie parametry dostawca zobowiązuje się utrzymywać i co przewiduje na wypadek spadku jakości usługi. Porównaj SLA z wymaganiami Twojej firmy: sprawdź, czy obejmuje dostępność API, przetwarzanie wiadomości, czas doręczenia, czy tylko wybrane elementy usługi.
Zwróć uwagę na okres pomiaru, wyłączenia i warunki wsparcia. Rozróżnij czas pierwszej odpowiedzi na zgłoszenie od ewentualnego zobowiązania do przywrócenia sprawności usługi. Twój zespół powinien wiedzieć kiedy może oczekiwać reakcji pomocy technicznej i jak będzie otrzymywał informacje o postępach.
Na tej podstawie przygotuj krótką procedurę:
- Wyznacz osobę koordynującą obsługę incydentu i jej zastępcę. Powinna móc uzgadniać działania IT, marketingu, obsługi klienta i dostawcy.
- Potwierdź ścieżkę eskalacji. Spisz sposób kontaktu, godziny dostępności wsparcia, kryteria pilności zgłoszeń i kolejny kontakt na wypadek braku odpowiedzi.
- Przygotuj dane do zgłoszenia. Uwzględnij czas wystąpienia problemu wraz ze strefą czasową, kanały, których dotyczy, identyfikatory wiadomości lub żądań, przykłady błędów oraz szacowany wpływ na klientów.
- Przypisz uprawnienia do decyzji o wysyłkach. Określ kto może wstrzymać kampanię, uruchomić uzgodniony wariant awaryjny i zatwierdzić wznowienie wysyłki.
- Przygotuj obsługę klienta. Zapewnij konsultantom dostęp do aktualnych informacji o incydencie i wskazówki co przekazywać osobom oczekującym na kody lub potwierdzenia.
Przećwicz scenariusz, w którym wiadomości są opóźnione, choć API pozostaje dostępne. Sprawdzisz w ten sposób, czy zespół potrafi rozpoznać problem odczuwalny przez klientów, określić jego pilność i zgłosić go właściwym osobom bez czekania na całkowitą awarię.
✅ Sprawdź przed Black Friday: czy każda zaangażowana osoba wie gdzie znaleźć procedurę, z kim się skontaktować i od czego zacząć. Uzupełnij brakujące ustalenia dotyczące odpowiedzialności i wsparcia zanim zmiany w harmonogramie kampanii staną się zbyt trudne.
Trzy pytania do dostawcy platformy komunikacyjnej przed Black Friday
Przekaż dostawcy prognozę wysyłek, listę wiadomości wymagających pilnego doręczenia i planowane godziny kampanii. Następnie zadaj trzy pytania, które pomogą przełożyć przegląd gotowości na konkretne ustalenia:
- Jaką przepustowość będzie miało nasze konto przy takim zestawie wysyłek w planowanym szczycie ruchu?
Poproś o potwierdzenie obowiązujących limitów, zmian wymagających wcześniejszego przygotowania oraz założeń, na których dostawca opiera swoją ocenę. - Co stanie się z wiadomościami, jeśli ruch przekroczy dostępną przepustowość lub zawiedzie jedna ze ścieżek wysyłki?
Ustal, które wiadomości otrzymają pierwszeństwo, które będą czekać, kiedy wygasną i ile ruchu przejmie infrastruktura zapasowa. Poproś o wyniki odpowiednich testów lub uzgodnij wspólną próbę. - Kto po stronie dostawcy zajmie się problemem podczas kampanii i jak się z nim skontaktujemy?
Potwierdź kontakt do eskalacji, godziny wsparcia, deklarowany czas reakcji i sposób informowania o postępach. Uzgodnij też jakie dane Twój zespół powinien dołączyć do pierwszego zgłoszenia.
Każdej nierozstrzygniętej kwestii przypisz osobę odpowiedzialną i termin zamknięcia. Jeśli nie uda się potwierdzić wydajności lub skuteczności procedur awaryjnych, dostosuj harmonogram albo wielkość wysyłek przed startem. Efektem przeglądu powinien być sprawdzony plan działania i jasna decyzja, które kampanie można uruchomić przy dostępnych zasobach.
Planujesz kampanię na Black Friday? Porozmawiajmy!
Przygotuj prognozowaną liczbę SMS-ów, e-maili i powiadomień push, harmonogram kampanii oraz listę wiadomości wymagających pilnego doręczenia. Omówimy skalowalność API, potrzebną przepustowość, zastosowanie MessageFlow Priority w komunikacji krytycznej i zakres wsparcia potrzebny Twojemu zespołowi podczas szczytu ruchu.
Porozmawiaj z ekspertem MessageFlow o planowanych wysyłkach i ustal co warto przygotować przed startem kampanii.